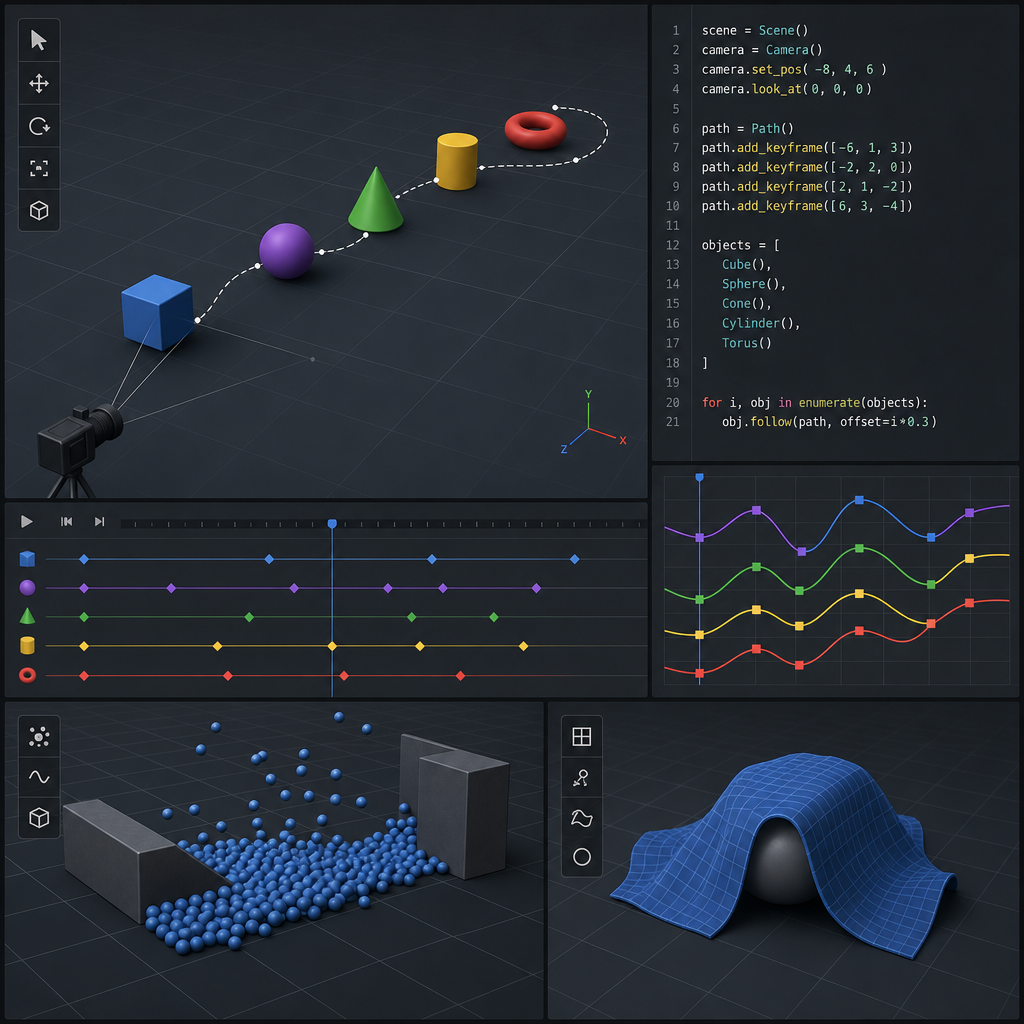
MS는 11일(현지시간) 실행 가능한 코드를 이용해 영상 생성 과정을 직접 다루는 코드 비디오 모델을 공개했다. 사용자가 장면을 설명하면 코딩 에이전트가 이를 프로그램으로 바꿔 객체 위치, 이동, 타이밍, 카메라 경로를 코드로 작성한다. 이어 물리 방정식으로 동작을 계산해 프록시 비디오와 참조 이미지를 만든다. 프록시 비디오는 1분 이내에 생성되는 미리보기 영상으로, 최종 영상 전에 장면 구조와 움직임을 확인하는 데 쓰인다.
이후 사전 학습된 R2V 모델이 프록시 비디오의 구조와 참조 이미지의 외관을 바탕으로 세부 영상을 만든다. 연구진은 기존 비디오 확산 모델이 객체 배치나 카메라 궤적을 내부적으로 정해 세부 수정이 어려웠던 한계를 줄였다고 설명했다. 또 프록시 비디오를 초기 샘플링 단계에서만 반영하는 초기 단계 조건화를 적용해, 초반에는 구조와 움직임을 유지하고 후반에는 외관과 화질을 살리도록 했다. 관련 가중치와 코드는 허깅페이스와 깃허브를 통해 제공된다.