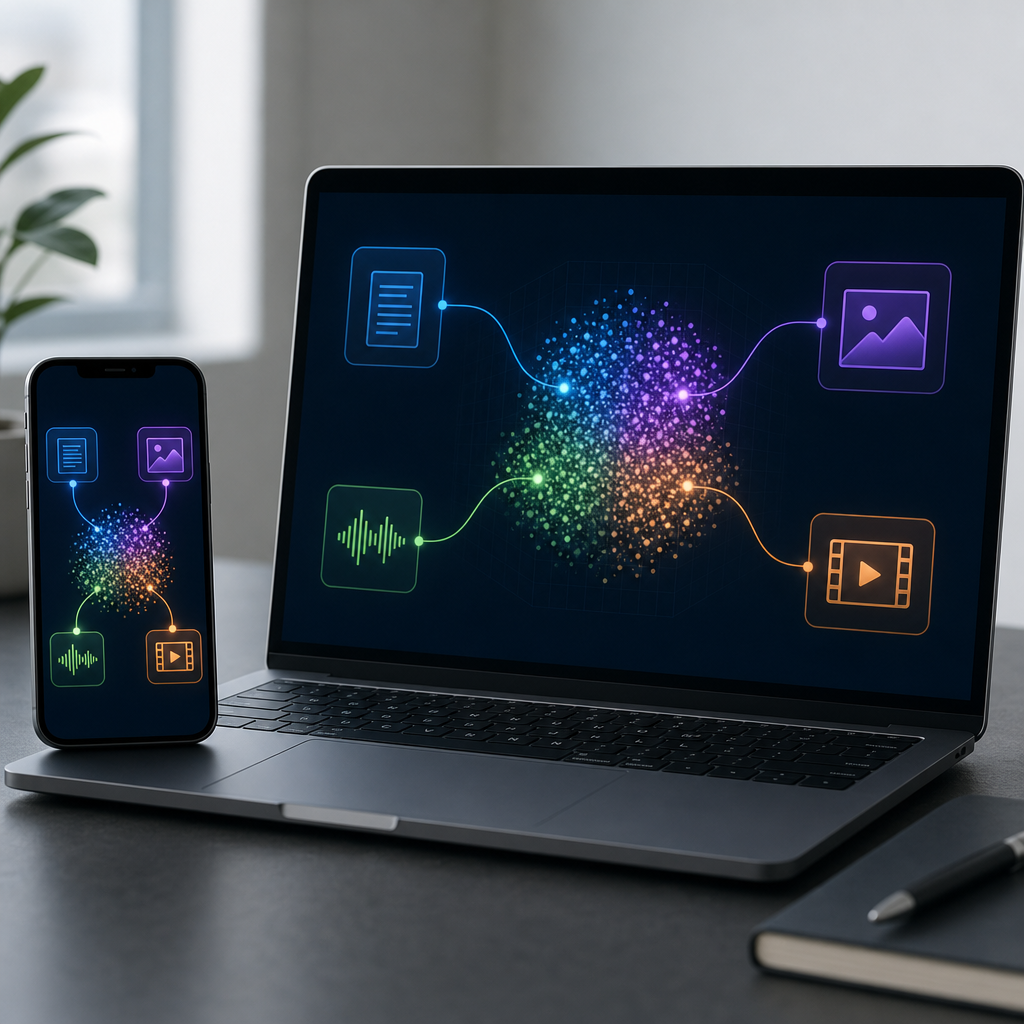
구글은 스마트폰과 PC 같은 소비자 기기에서 직접 구동하는 경량 멀티모달 임베딩 모델 ‘임베딩젬마 2’를 공개했다. 이 모델은 젬마 4 아키텍처 기반의 740M 매개변수 모델로, 텍스트뿐 아니라 코드, 이미지, 비디오, 오디오를 하나의 벡터 공간에서 처리한다. 임베딩은 여러 형태의 데이터를 수치로 바꿔 유사도를 비교하고 관련 정보를 찾는 기술이다. 이번 모델은 아파치 2.0 라이선스로 공개됐고, 필요한 기능만 선택해 쓰는 모듈형 구조를 적용해 텍스트 전용 작업에서는 자원 사용을 더 줄일 수 있다.
기술적으로 중요한 점은 온디바이스 검색과 검색증강생성 활용 범위를 넓혔다는 데 있다. 최대 8192토큰 컨텍스트를 지원하며, 한 번에 최대 29장 이미지, 58개 비디오 프레임, 5.5분 오디오를 처리할 수 있다. 텍스트로 사진을 찾거나 음성 메모로 관련 영상을 검색하는 식의 혼합 입력도 가능하다. 코드와 음성 검색 성능도 개선됐고, 벡터 차원을 줄이는 MRL로 저장 공간과 메모리 사용량을 최대 6배 절감할 수 있다고 구글은 설명했다. 허깅페이스와 캐글에서 가중치를 배포하며 MediaPipe와 LiteRT 기반 온디바이스 배포도 지원한다.