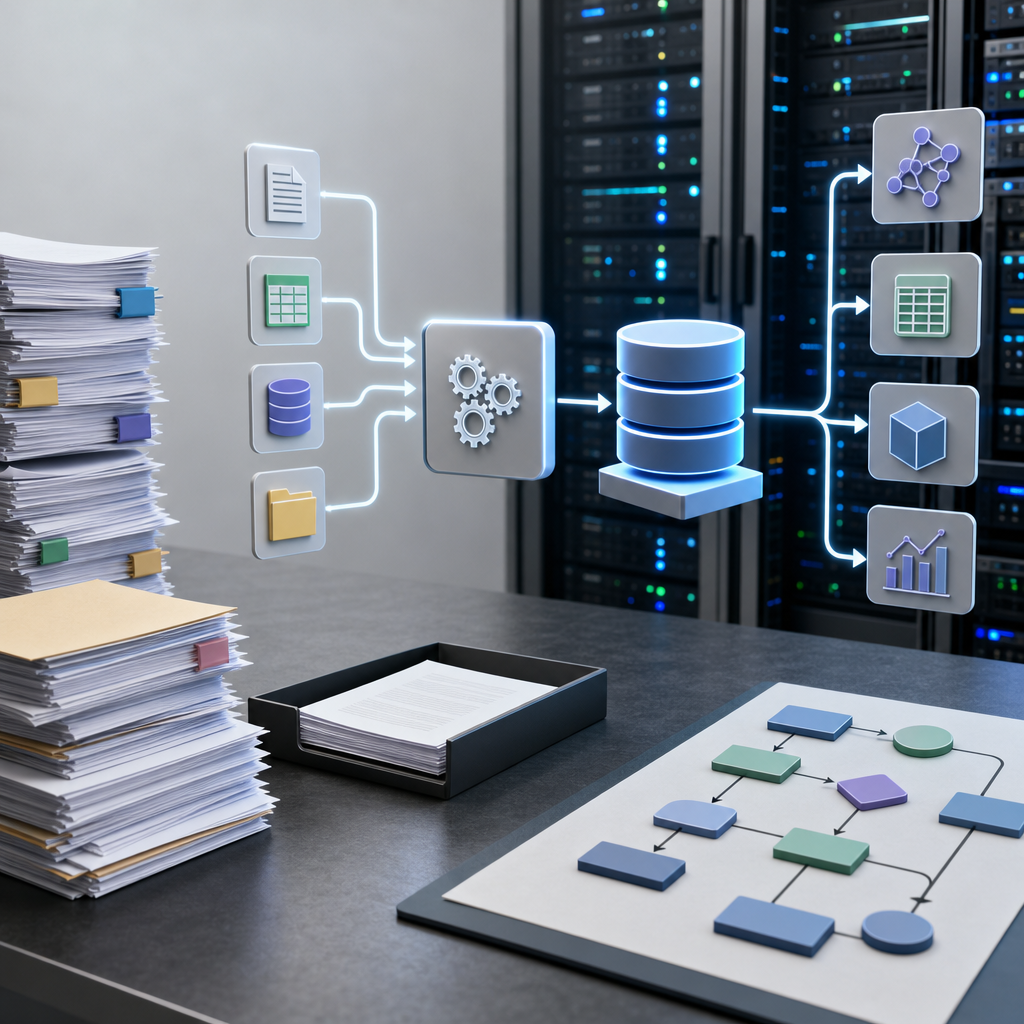
한국딥러닝은 기업 AI 도입의 기준이 ‘AI-레디 데이터’에서 ‘에이전트-레디 데이터’로 바뀌고 있다고 설명했다. 기사에 따르면 기업은 성능이 높은 LLM을 써도 내부 데이터의 품질이 낮거나 맥락이 정리되지 않으면 실제 업무 적용이 어렵다는 점을 경험해 왔다. 가트너도 8월27일 보고서에서 기업의 데이터와 관리 체계가 에이전틱 AI의 요구를 지원하고, 에이전트의 데이터 사용 방식까지 평가해야 한다고 제시했다. 준비된 데이터가 단순히 AI가 이해할 수 있는 수준에 머물면, 실제 업무 처리 단계에서 부정확한 응답이나 데이터 오용이 생길 수 있다는 설명이다.
이 글은 에이전트에게 필요한 것이 정보 자체보다 ‘업무 상태’를 판단할 수 있는 데이터라고 본다. 예시로 든 기업대출 심사에서는 고객정보, 거래내역, 신용정보 같은 정형 데이터와 사업자등록증, 재무제표, 납세증명서 등 문서를 함께 다뤄야 한다. 여기서 중요한 것은 값 추출만이 아니라, 문서의 출처와 대상 업무의 연결, 다른 자료와의 일치 여부, 필수 서류 충족 여부, 적용 규칙과 현재 처리 상태를 함께 유지하는 일이다. 그래야 새로운 문서가 들어왔을 때 에이전트가 상태를 다시 판단하고 다음 처리를 결정할 수 있다.