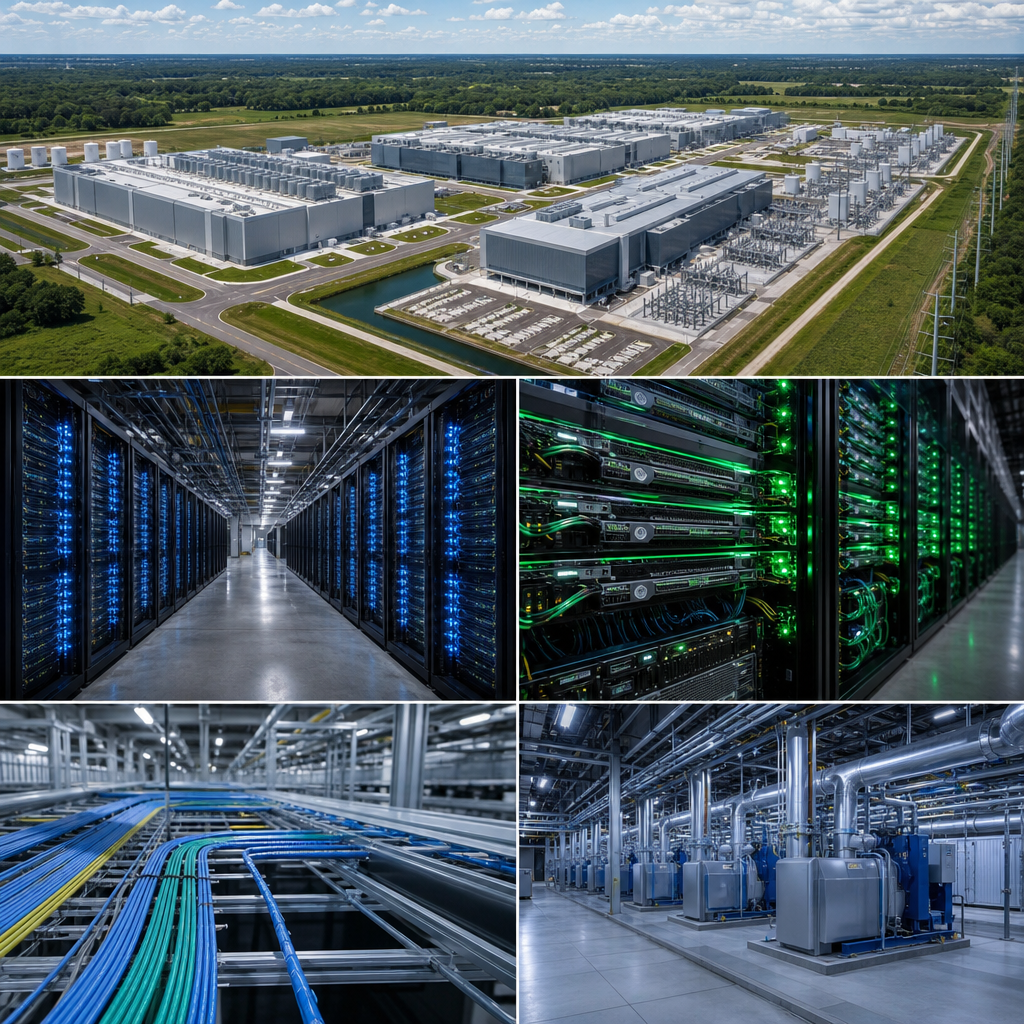
Meta는 미국 오하이오주 뉴올버니 데이터센터에 구축 중인 AI 인프라 ‘Prometheus’를 소개했다. 이 시설은 여러 건물에 걸친 수십만 개 GPU를 광섬유로 촘촘히 연결해 하나의 시스템처럼 동작하도록 설계됐다. 기존에는 웹 트래픽을 처리하던 일반 데이터센터 부지였지만, 하드웨어·네트워크·건물 설계를 바꿔 최전선 모델 학습용으로 전환했다. 현재는 단계적으로 확장 중이며, 첫 단계는 이미 완료돼 Muse 기초 모델과 Muse Wonder 모델 학습에 사용됐다.
기술적으로 핵심은 대규모 학습에서 성능 저하를 막는 안정성과 연속성이다. Meta는 단일 호스트 문제도 전체 작업을 늦추거나 멈출 수 있다고 설명했고, 이를 줄이기 위해 시스템 안정성과 신뢰성을 높였다. 그 결과 Muse Wonder 사전학습에서는 goodput 85% 이상, 강화학습 실행에서는 90% 이상을 기록했다. 학습 중 평균 중단 간격은 약 4만7000 GPU 시간에서 펌웨어 수정 뒤 5만4000 GPU 시간을 넘겼다. Prometheus는 완성 시 약 100만 개 분산 GPU가 함께 동작하는 규모로 커질 예정이다.