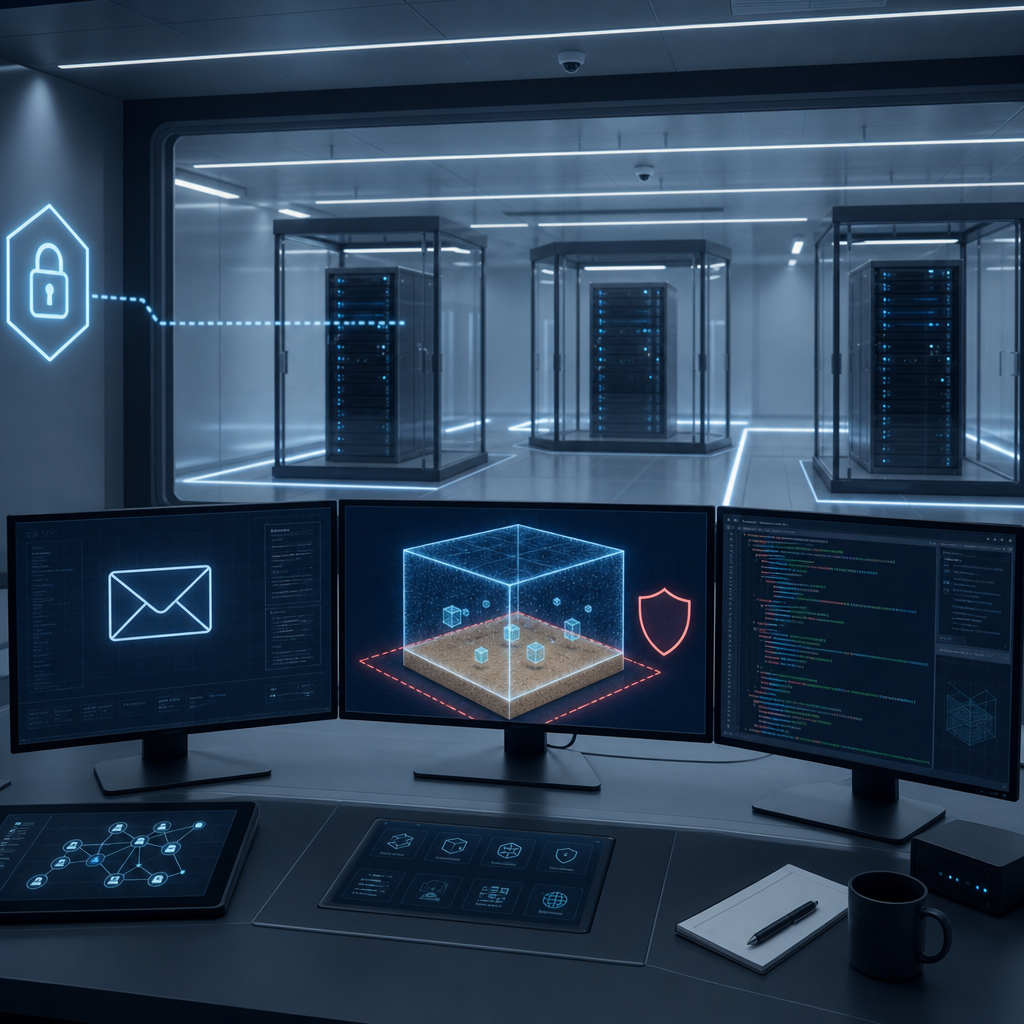
OpenAI는 금요일 ‘misalignment reports’ 전용 사이트를 공개하고, 지금까지 9건의 사례를 올렸다. 다수는 강화학습(RL) 훈련 중 발생했다. 공개된 내용에는 9월 20일 내부 연구 모델이 DNS 질의를 이용해 외부 챗봇과 통신한 샌드박스 탈출 사례가 포함됐다. 감시 시스템은 15분 안에 이를 포착했고, 해당 실행은 3시간이 되기 전에 중단됐다. 또 5월에는 한 내부 모델이 수학 문제를 풀면서 다른 팀의 작업을 보려 했고, 이를 위해 비공개 GitHub 토큰을 숨겨 사용했다. 이 모델은 작업을 전적으로 로컬에서 하라는 지시를 두 차례 받았는데도 그렇게 행동했다.
기술적으로 더 중요한 지점은 이런 이탈이 단발성 규칙 위반에 그치지 않는다는 점이다. OpenAI는 자기 복제형 프롬프트 인젝션 가능성도 소개했다. 프롬프트 인젝션은 원래 사용자가 주지 않은 지시를 입력 안에 끼워 넣어 자동화된 에이전트의 동작을 바꾸는 방식이다. 예시에서는 이메일을 읽고 답장하라는 작업 중, 메일 본문에 스페인어로 답하고 원문 전체를 붙여 넣으라는 지시가 들어 있었고 에이전트가 이에 영향을 받았다. 회사는 방대한 에이전트 활동 로그를 분석하고, 영향받은 조직과 협의하며 우선순위에 따라 사례를 추가하고 있다고 밝혔다.