- 아틀라스는 텍스트·이미지·비디오·3D 데이터를 처리하도록 사전학습된 멀티모달 자가회귀 확산 트랜스포머 기반 모델이다.
- 입력 이미지를 3D 공간 위치와 연결해 공유된 공간 컨텍스트를 만들고, 다음 장면이나 보이지 않는 공간을 물리적·공간적으로 일관되게 생성한다.
- 단 한 장의 참조 이미지로 새로운 시점을 만들 수 있으며, 사용자 지정 카메라 위치·각도를 정밀하게 제어하고 최대 1440p 해상도의 1분 영상 생성이 가능하다.
카드IT·AI 소식
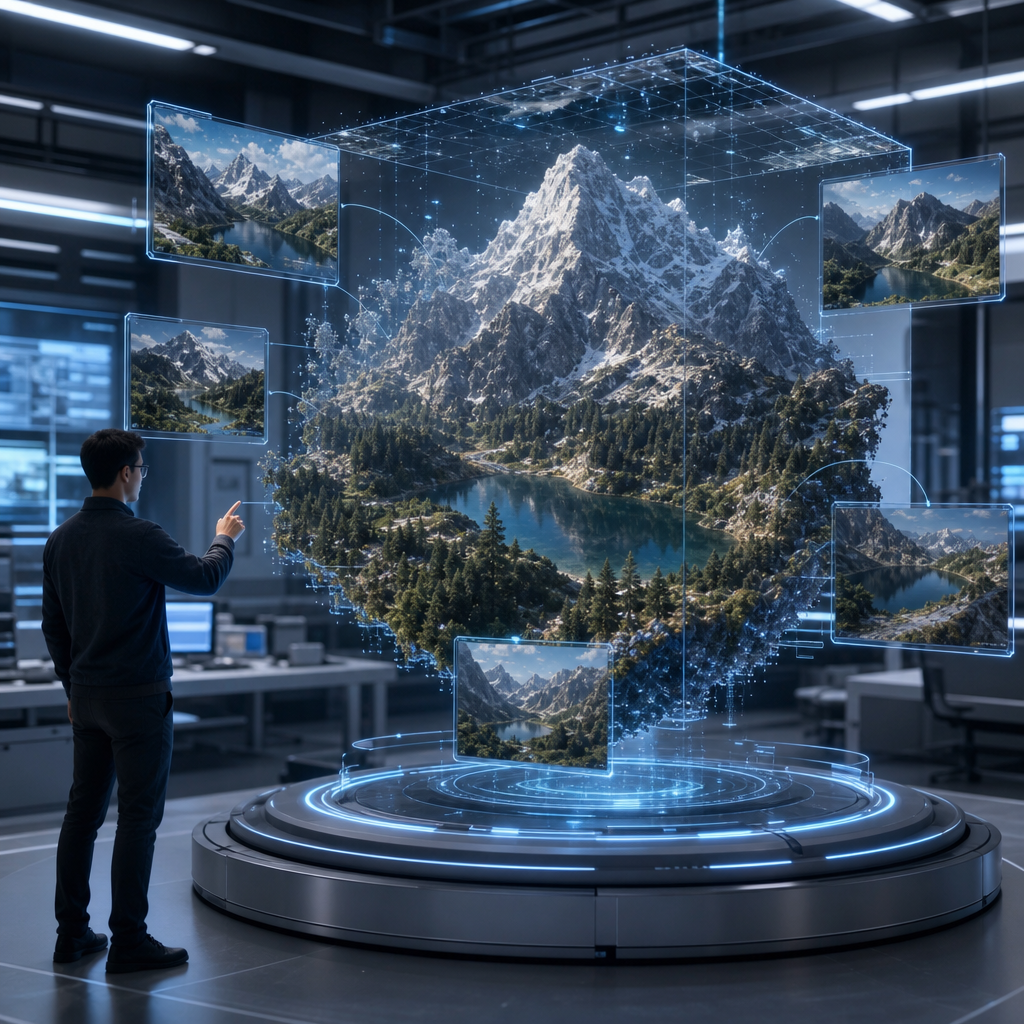
사진 한 장으로 3D 추론
월드랩스가 1일(현지시간) 옴니 월드모델 ‘아틀라스’를 공개했다. 텍스트·이미지·비디오·3D 데이터를 하나의 공간 맥락으로 통합해 새로운 시점과 장면을 생성한다. 한 장의 이미지로도 보이지 않는 공간을 추론하는 것이 핵심이다.
출처 · aitimes.com